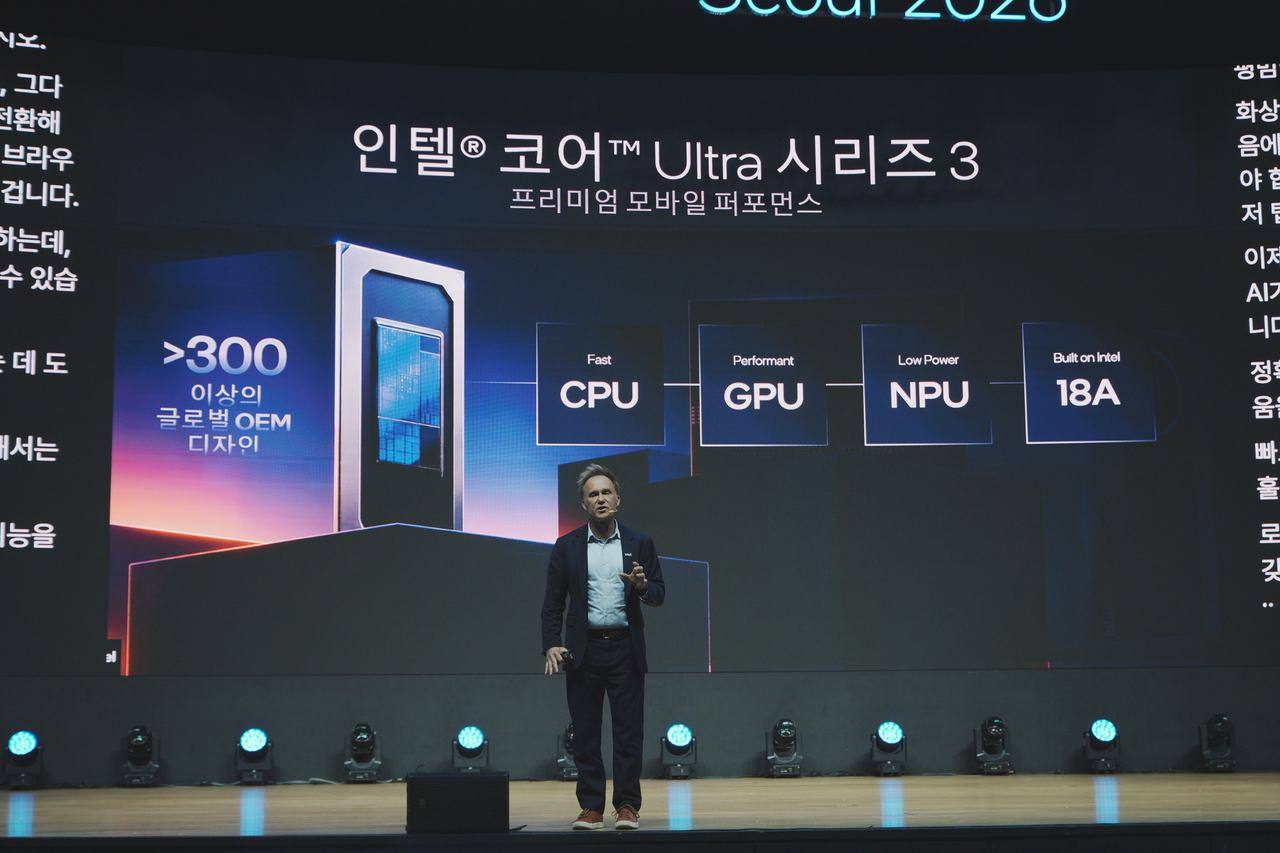
| 1 | 컴퓨팅 구조 | 이기종 컴퓨팅 | Heterogeneous Computing | CPU, GPU, NPU, 가속기처럼 성격이 다른 칩을 한 시스템에 섞어, 각자 잘하는 일을 나눠 맡기는 방식입니다. 이번 서밋 전체를 꿰는 핵심어였습니다. |
| 2 | 컴퓨팅 구조 | CPU | Central Processing Unit | 컴퓨터의 두뇌. 순서대로 판단하고 여러 작업을 조율하는 일에 강합니다. 에이전트 시대에 다시 중요해진다는 이야기가 많았습니다. |
| 3 | 컴퓨팅 구조 | GPU | Graphics Processing Unit | 같은 계산을 한꺼번에 많이 하는 칩. AI 모델 학습과 큰 모델의 추론에 주로 씁니다. |
| 4 | 컴퓨팅 구조 | NPU | Neural Processing Unit | AI 계산만 저전력으로 하는 칩. AI PC에 들어가 배터리를 아끼며 음성 인식 같은 상시 AI를 돌립니다. |
| 5 | 컴퓨팅 구조 | SoC | System on Chip | CPU, GPU, NPU 등을 칩 하나에 모아 담은 것. 코어 울트라 시리즈 3가 그 예입니다. |
| 6 | 컴퓨팅 구조 | 오케스트레이션 · Control Plane | Orchestration · Control Plane | 여러 모델과 도구에 일을 나눠 주고 순서를 정하는 지휘 역할. 발표에서는 CPU가 이 역할을 맡는다고 했습니다. |
| 7 | AI 종류 | 에이전틱 AI | Agentic AI | 질문에 답만 하는 AI가 아니라, 목표를 받으면 계획을 세우고 도구를 써서 일을 끝까지 해내는 AI입니다. |
| 8 | AI 종류 | Plan → Act → Observe | Plan · Act · Observe | 에이전트가 일하는 순서. 계획하고, 실행하고, 결과를 확인해 틀렸으면 다시 계획합니다. |
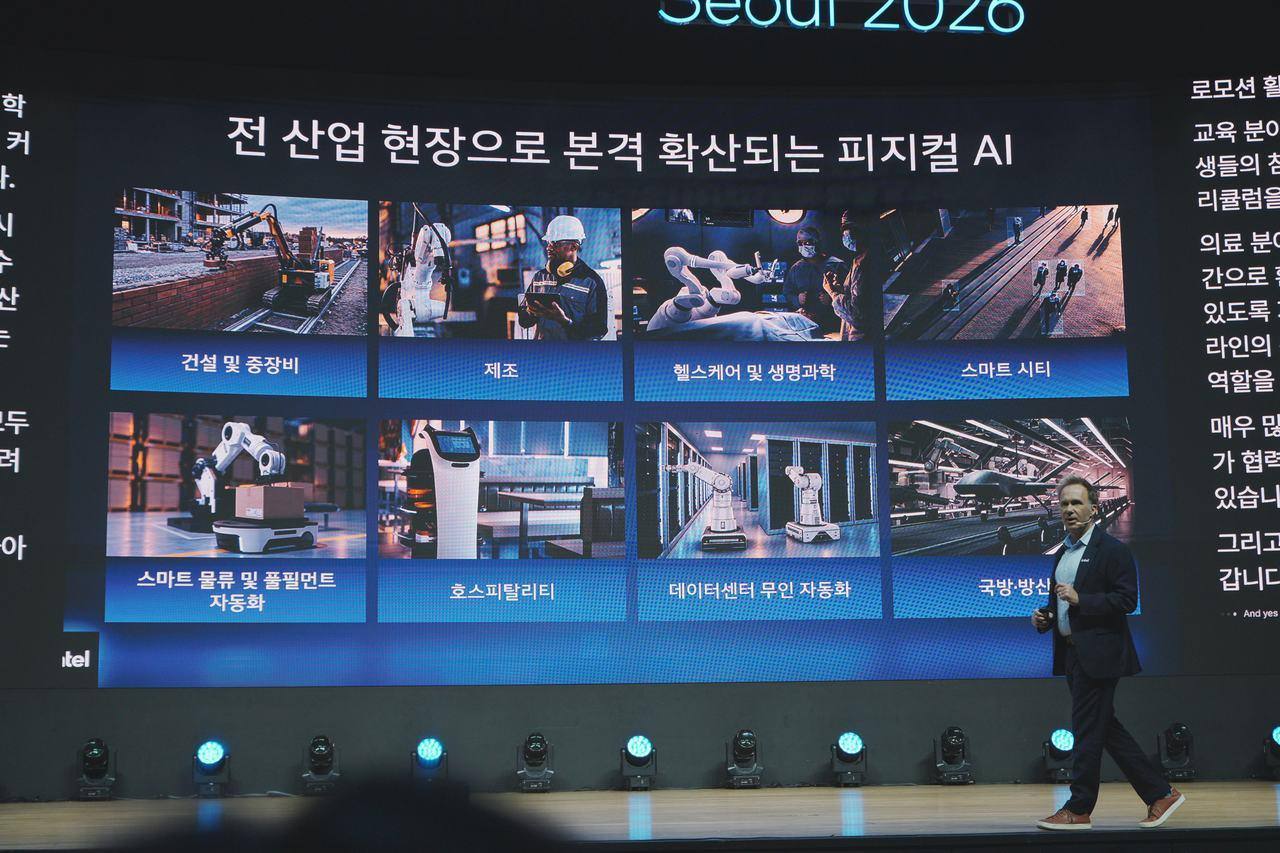
| 9 | AI 종류 | 피지컬 AI | Physical AI | 로봇, 자율주행, 공장 설비처럼 현실 세계를 보고 판단해 직접 움직이는 AI입니다. |
| 10 | AI 종류 | VLM · VLA | Vision Language Model · Vision Language Action | VLM은 이미지를 보고 말로 이해하는 모델, VLA는 거기에 행동(로봇 팔 움직임 등)까지 내놓는 모델입니다. |
| 11 | AI 종류 | 소버린 AI | Sovereign AI | 나라나 기업이 남의 인프라에 기대지 않고 자기 데이터와 시설로 AI를 운영할 수 있는 상태. 'AI 주권'이라고도 합니다. |
| 12 | AI 종류 | 퍼스널 AI | Personal AI | 클라우드가 아니라 내 기기 안에서 내 데이터로 돌아가는 개인 맞춤 AI입니다. |
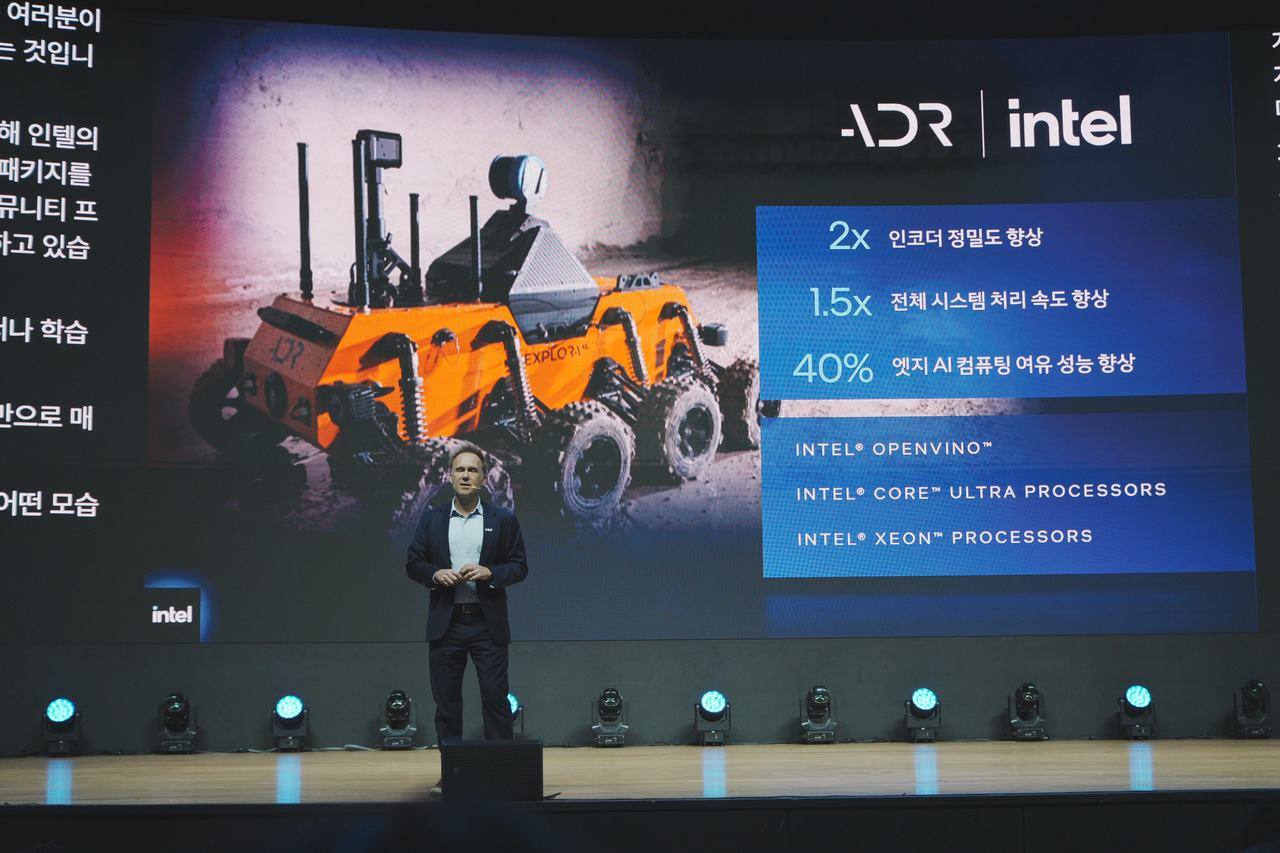
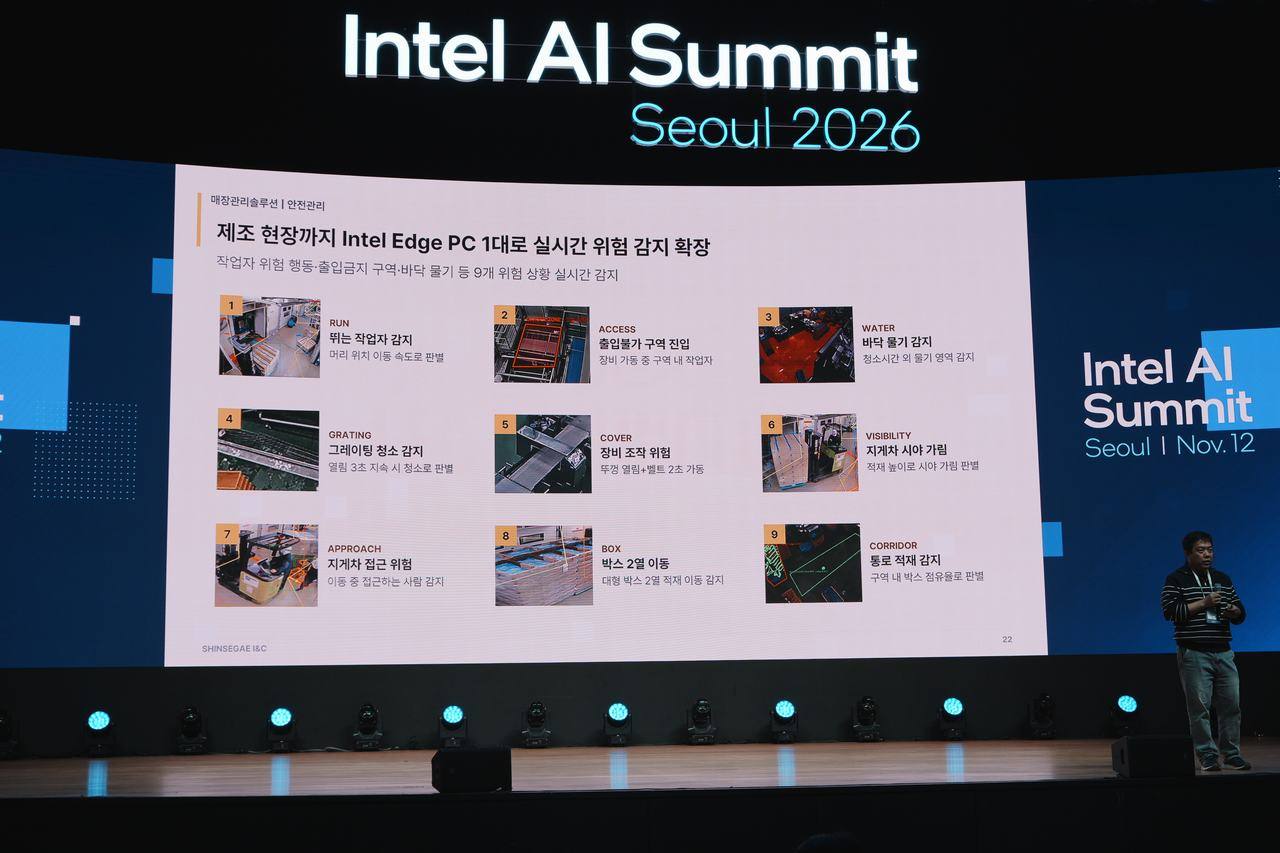
| 13 | AI 종류 | 엣지 AI · 온디바이스 AI | Edge AI · On-device AI | 데이터센터로 보내지 않고 데이터가 생기는 현장(PC, 카메라, 로봇)에서 바로 처리하는 AI. 빠르고 개인정보가 밖으로 나가지 않습니다. |
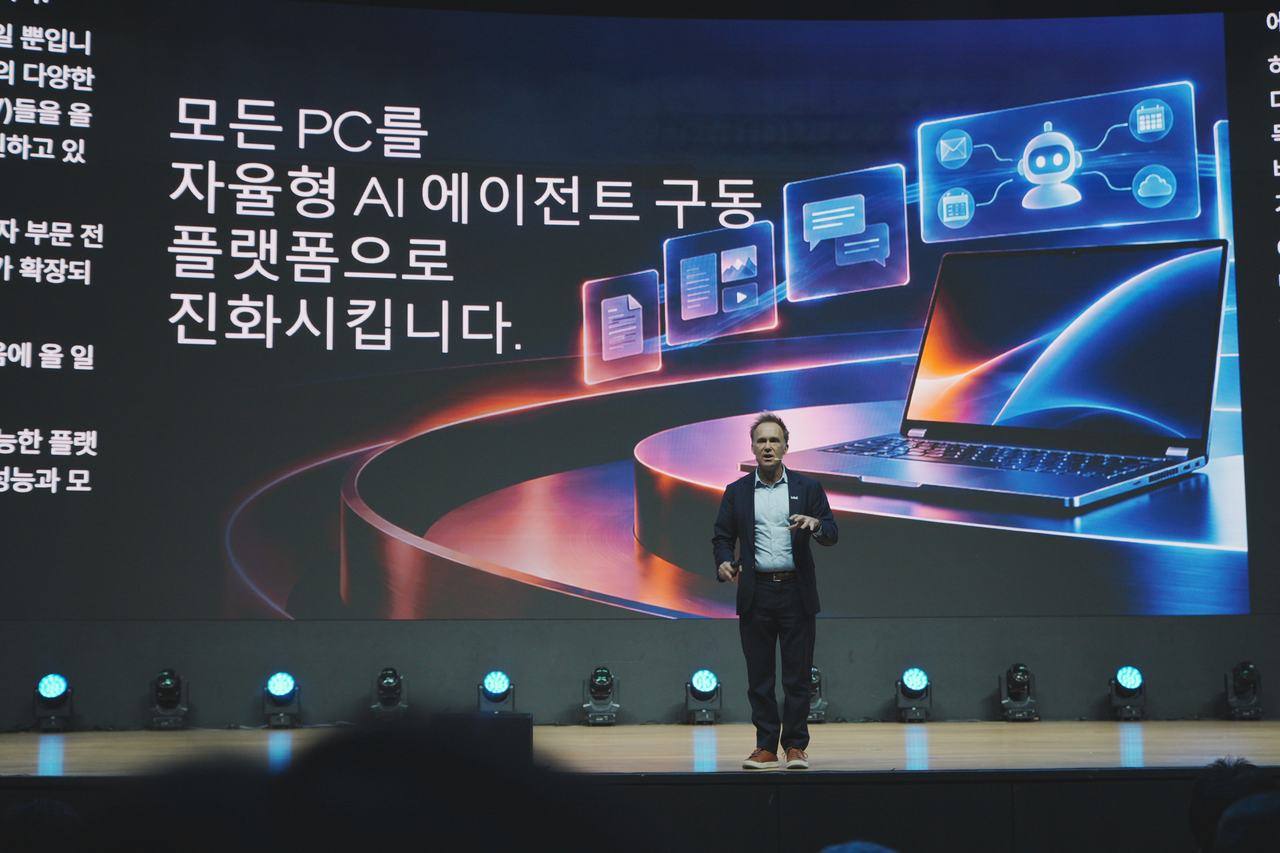
| 14 | AI 종류 | Computers for Agents | Computers for Agents | 사람이 아니라 AI 에이전트가 주 사용자가 되는 컴퓨터. 인텔이 PC의 다음 단계로 제시한 개념입니다. |
| 15 | 추론 과정 | 추론 | Inference | 이미 학습된 AI 모델이 질문을 받아 답을 만들어 내는 단계. 학습(Training)과 구분합니다. |
| 16 | 추론 과정 | 토큰 | Token | AI가 글을 읽고 쓰는 최소 단위. 대략 단어 조각이라고 보면 되고, AI 사용료도 토큰 수로 매깁니다. |
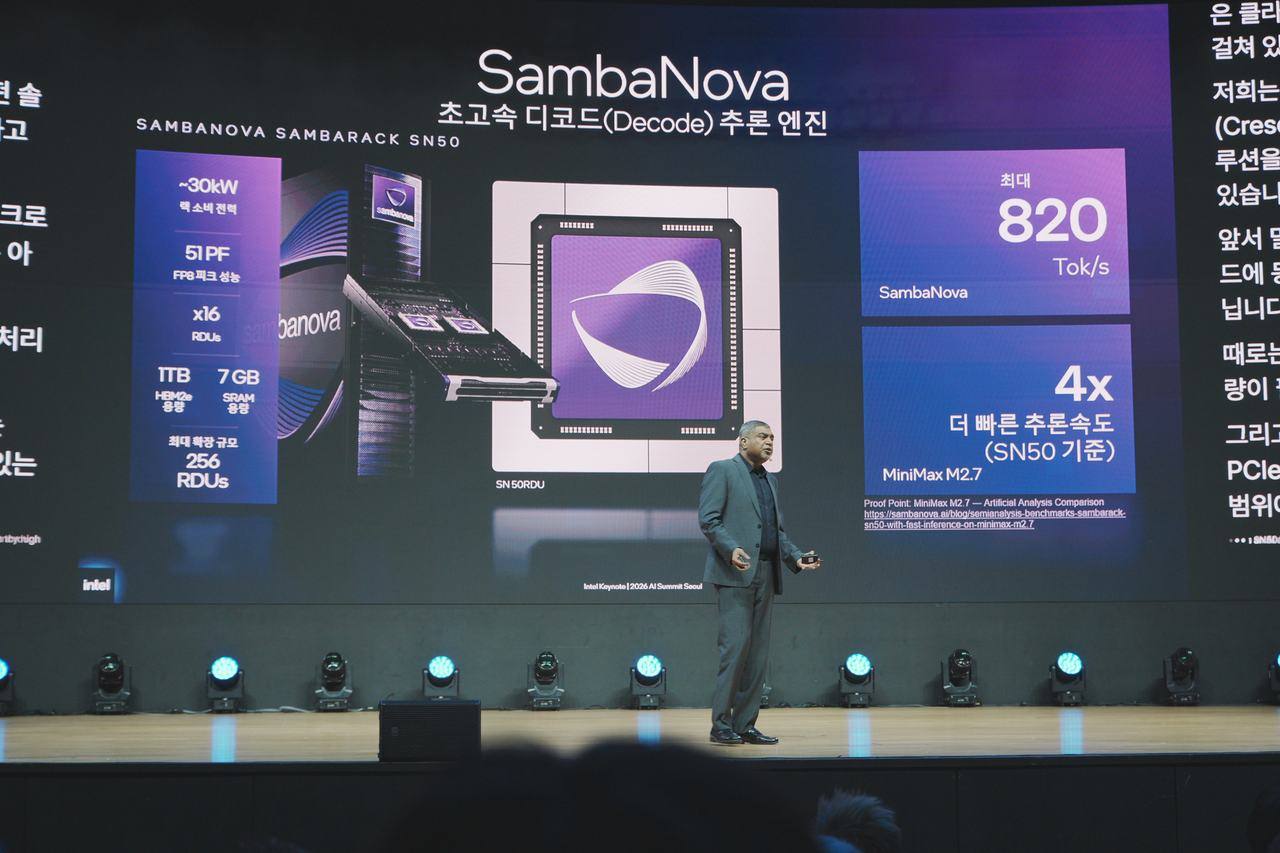
| 17 | 추론 과정 | 프리필 · 디코드 | Prefill · Decode | 프리필은 입력 문장을 한꺼번에 읽어 들이는 단계(계산이 많음), 디코드는 답을 한 토큰씩 써 내려가는 단계(메모리 속도가 중요)입니다. |
| 18 | 추론 과정 | KV 캐시 | Key-Value Cache | 대화 앞부분을 다시 계산하지 않도록 AI가 메모리에 적어 두는 메모장. 대화가 길어질수록 커집니다. |
| 19 | 추론 과정 | Tail Latency | Tail Latency | 가장 느린 응답(상위 1% 등)의 대기 시간. 평균보다 '가끔 심하게 느린 경우'를 볼 때 씁니다. |
| 20 | 추론 과정 | 양자화 | Quantization (INT4 등) | 모델의 숫자 정밀도를 낮춰 크기와 메모리를 줄이는 기술. INT4는 숫자 하나를 4비트로 줄인 것입니다. |
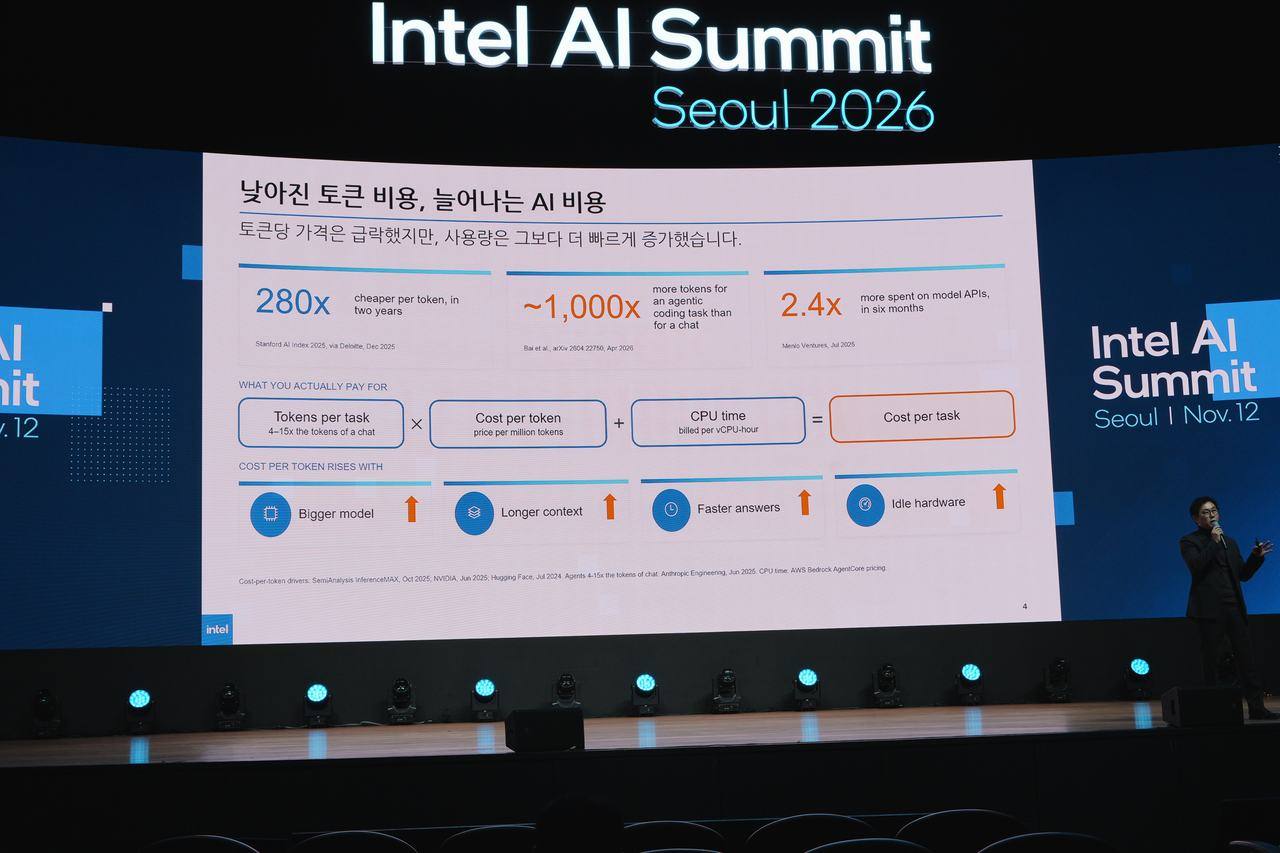
| 21 | 비용 · 설계 | Cost per Task | Cost per Task | 토큰 하나의 값이 아니라 일 하나를 끝내는 데 드는 전체 비용. 토큰 수, 토큰 단가, CPU 사용 시간을 합쳐 봅니다. |
| 22 | 비용 · 설계 | TCO | Total Cost of Ownership | 장비를 사서 운영하는 동안 드는 전체 비용. 구매가뿐 아니라 전기료, 유지비까지 포함합니다. |
| 23 | 비용 · 설계 | Right-Sized Infrastructure | Right-Sized Infrastructure | 무조건 크게가 아니라 일의 크기와 성격에 맞춰 알맞게 짠 인프라. 아닐 난두리 CVP 발표 주제입니다. |
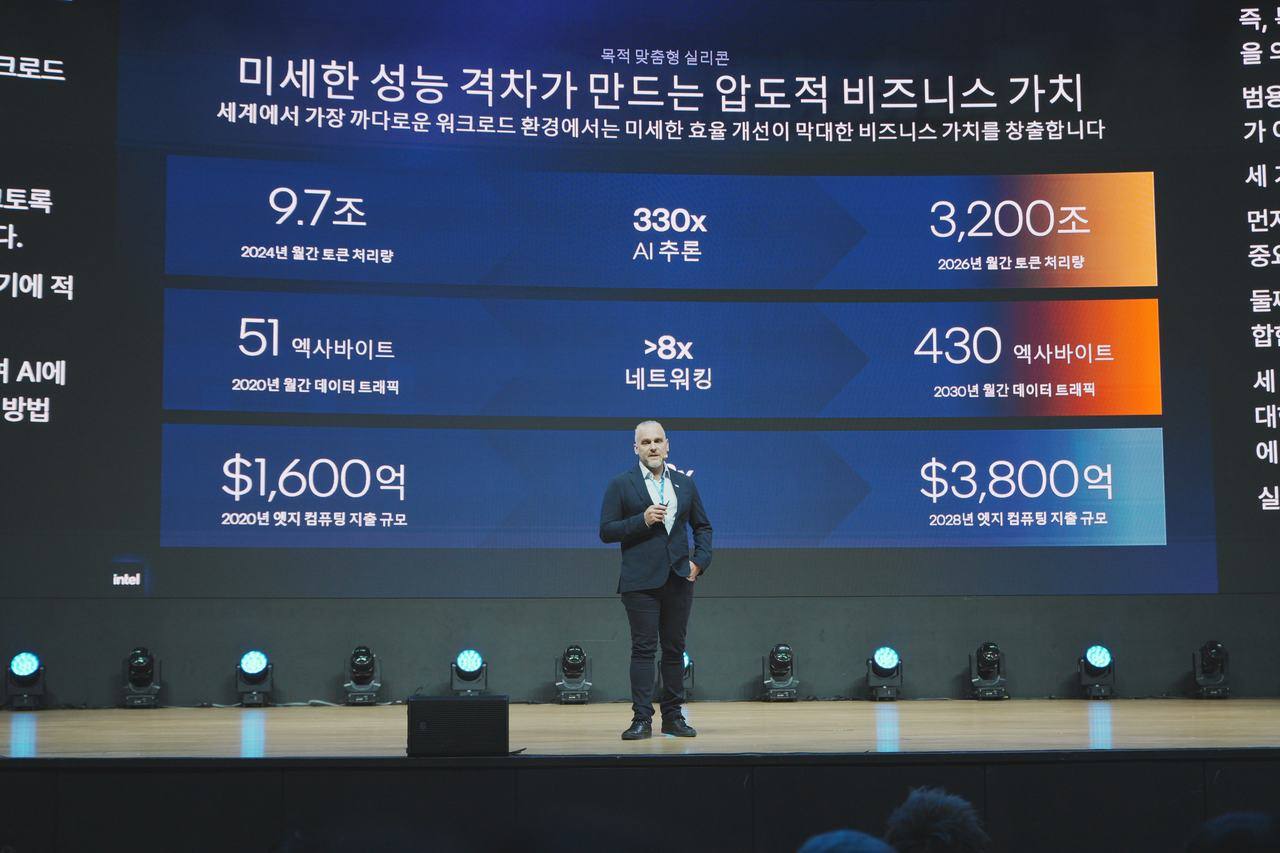
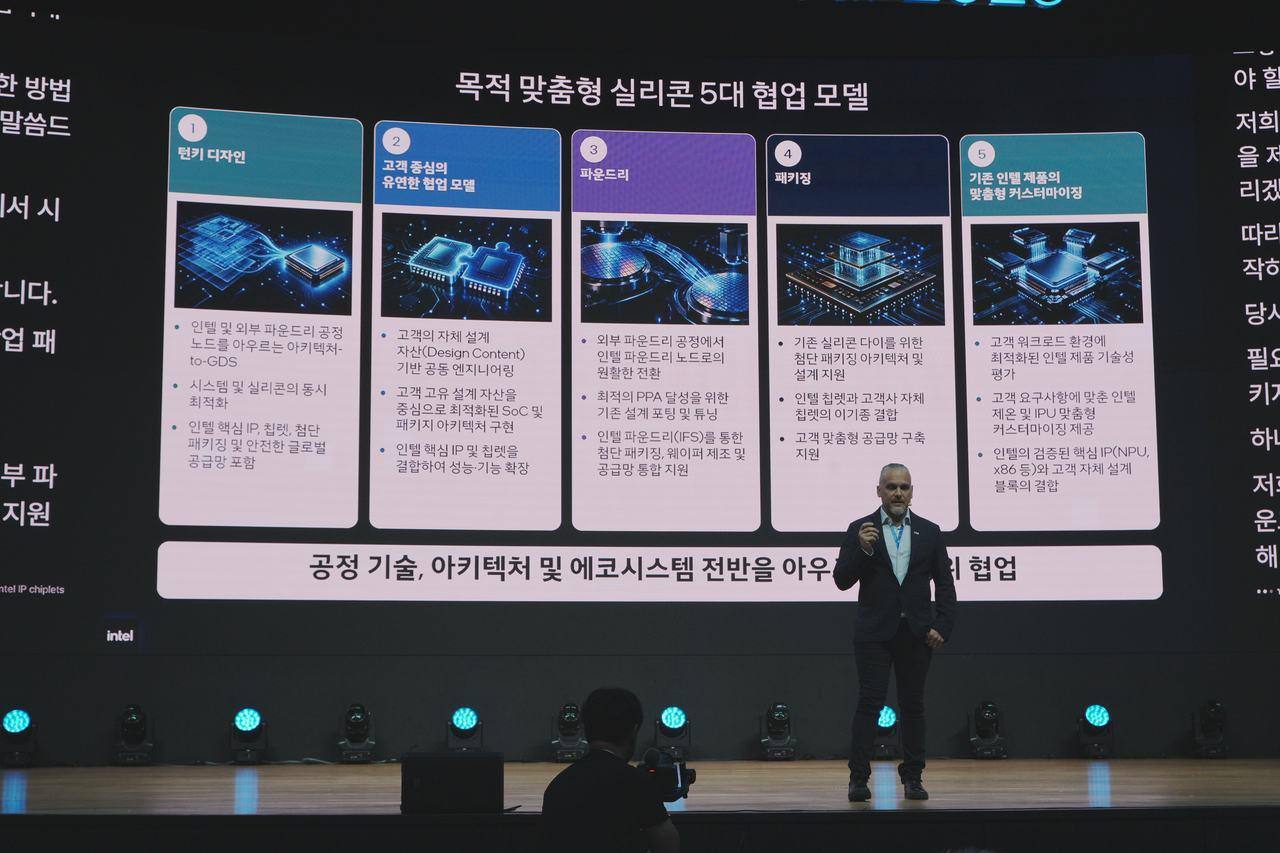
| 24 | 비용 · 설계 | Purpose-Built Silicon | Purpose-Built Silicon | 범용 칩 대신 특정 작업에 맞춰 처음부터 설계한 맞춤형 칩. 마커스 로렌스 CVP 발표 주제입니다. |
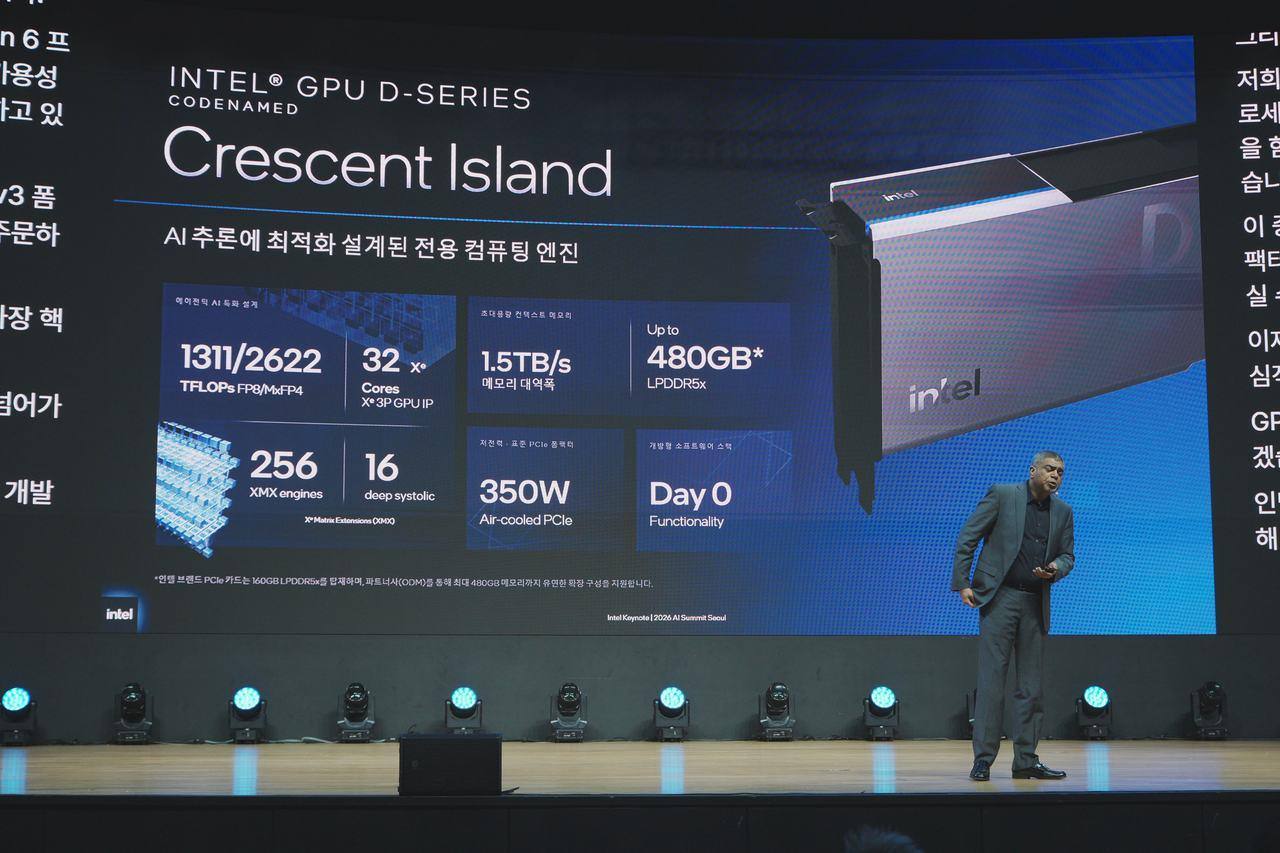
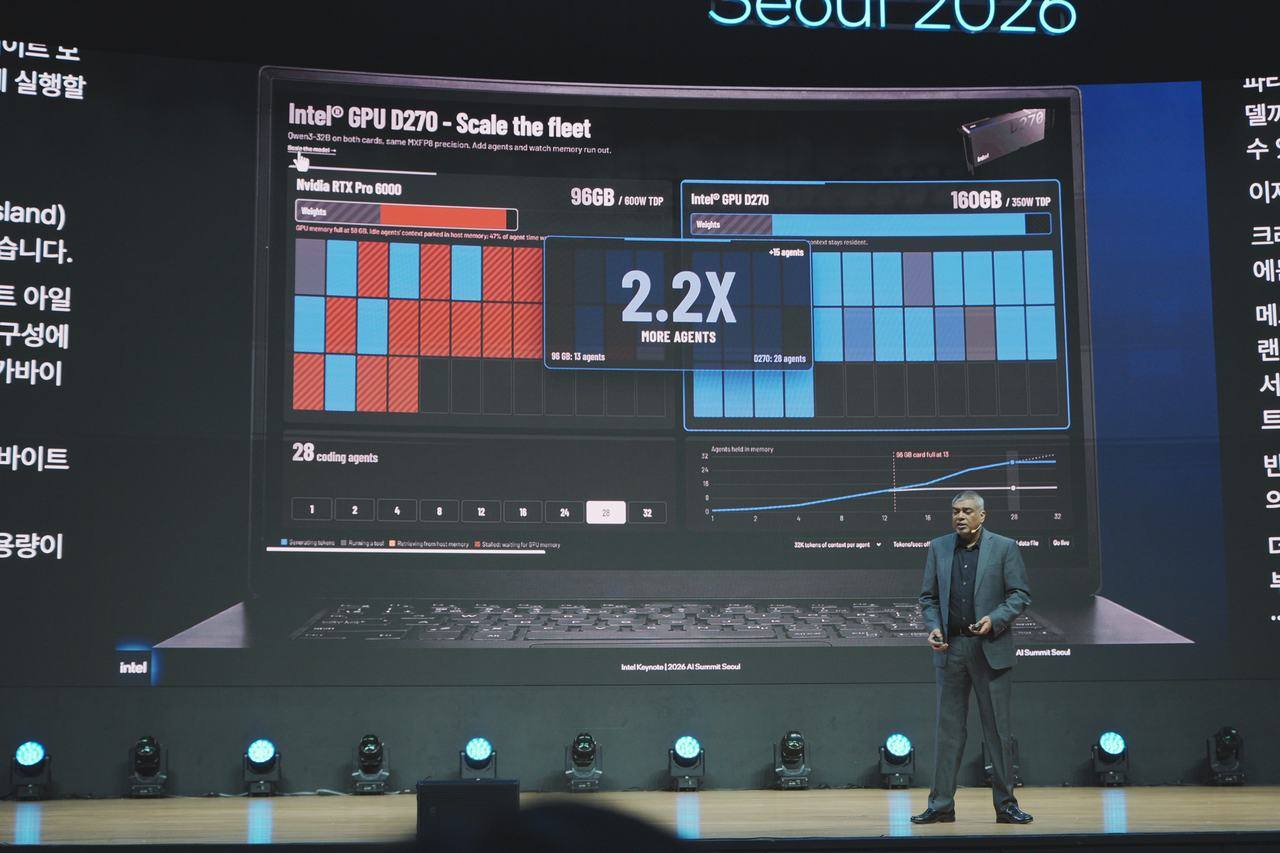
| 25 | 비용 · 설계 | TDP | Thermal Design Power | 칩이 쓰는 최대 전력(발열) 기준. 크레센트 아일랜드는 350W, RTX Pro 6000은 600W로 비교했습니다. |
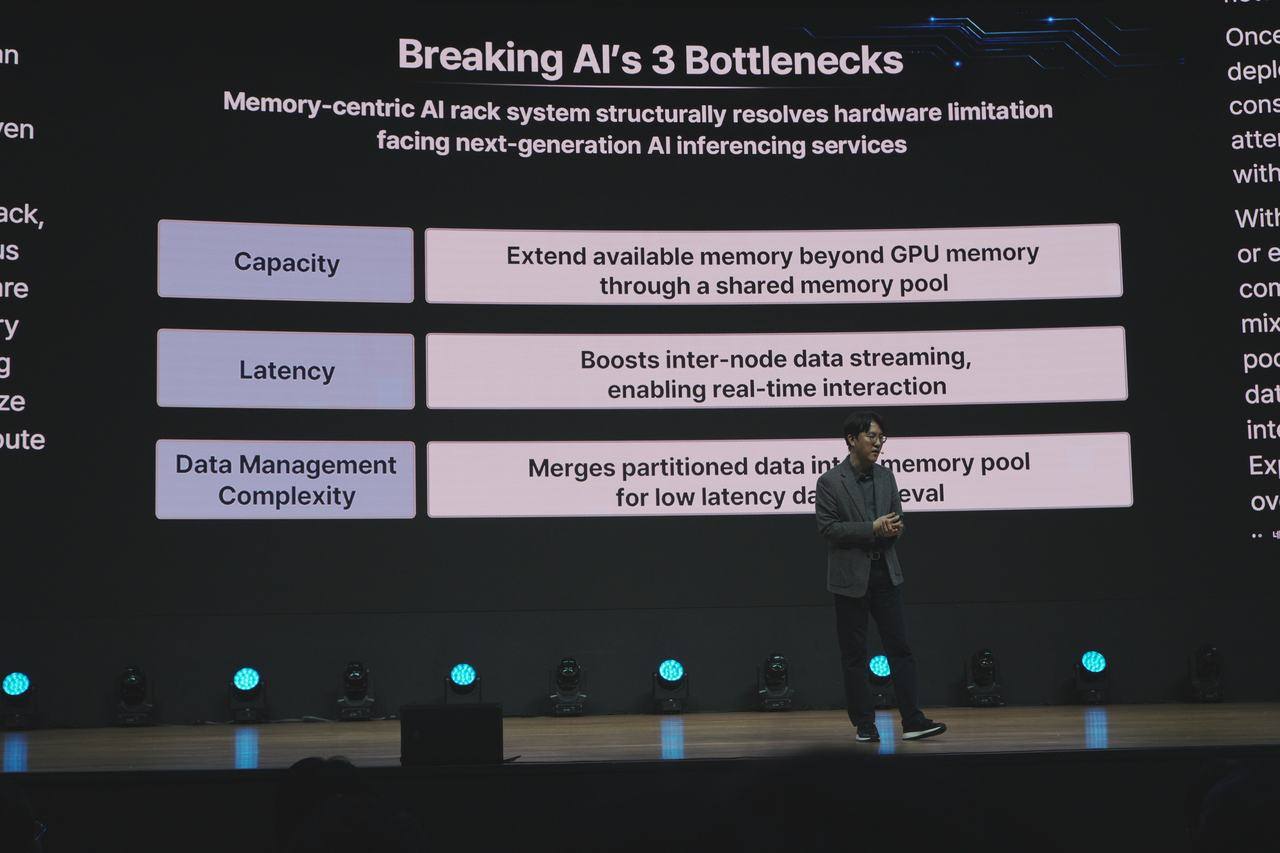
| 26 | 메모리 | Memory Wall | Memory Wall | 계산 속도는 빨라지는데 메모리 용량·속도가 따라가지 못해 생기는 한계입니다. |
| 27 | 메모리 | HBM · LPDDR5x | High Bandwidth Memory · Low Power DDR5x | HBM은 매우 빠르지만 비싸고 용량이 작은 메모리, LPDDR5x는 휴대폰에도 쓰는 저전력 메모리입니다. 크레센트 아일랜드는 LPDDR5x로 용량을 키웠습니다. |
| 28 | 메모리 | Memory-Centric System | Memory-Centric System | GPU마다 메모리를 붙이는 대신, 큰 메모리 창고(메모리 풀)를 가운데 두고 여러 서버가 나눠 쓰는 구조. SK하이닉스 제안입니다. |
| 29 | 메모리 | CXL · RDMA | Compute Express Link · Remote Direct Memory Access | CXL은 서버 안에서 칩과 메모리를 빠르게 잇는 연결 규격, RDMA는 서버끼리 메모리를 직접 주고받는 기술입니다. |
| 30 | 인텔 제품 · 기술 | 크레센트 아일랜드 · D270 | Crescent Island · Intel GPU D270 | 이번에 공개한 데이터센터용 AI 추론 GPU. 크레센트 아일랜드는 코드명, D270은 제품명입니다. 아직 출시 전입니다. |
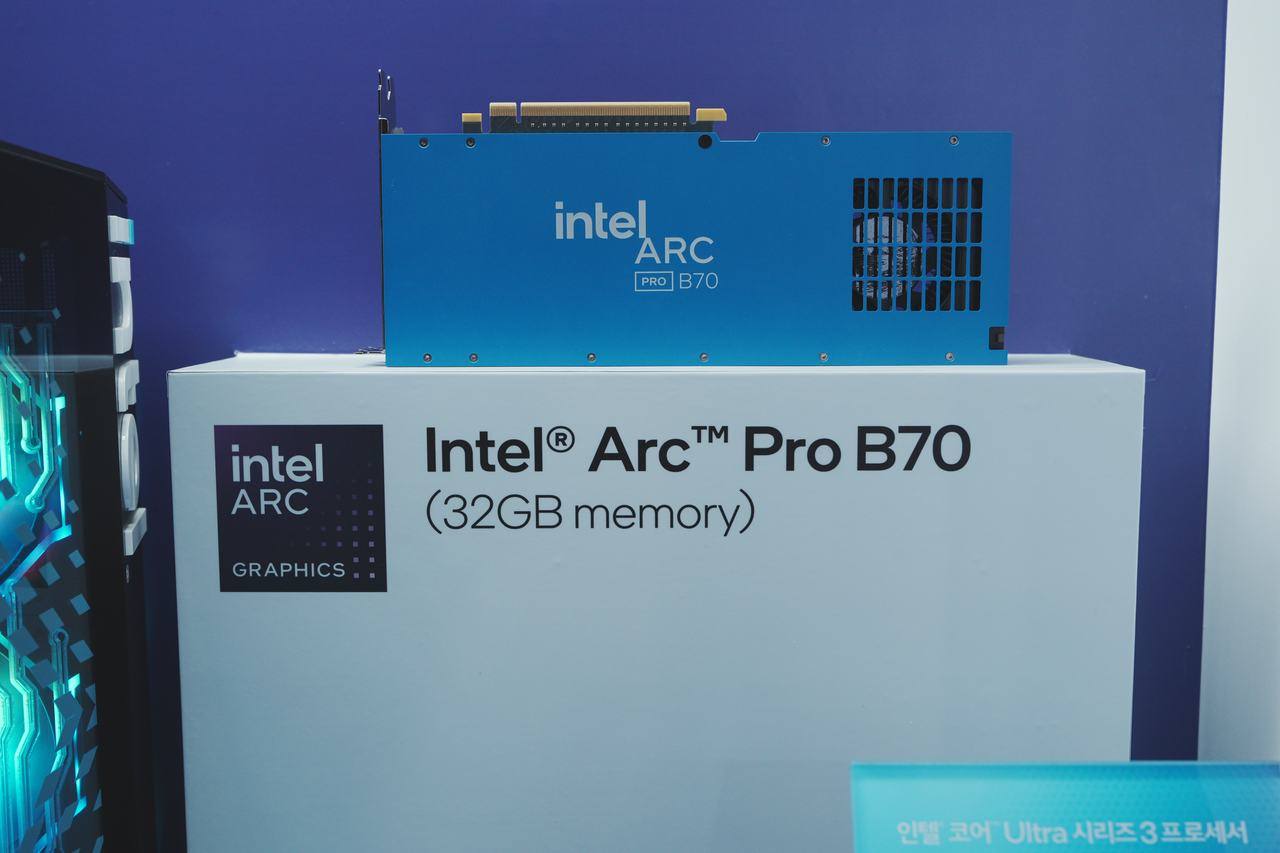
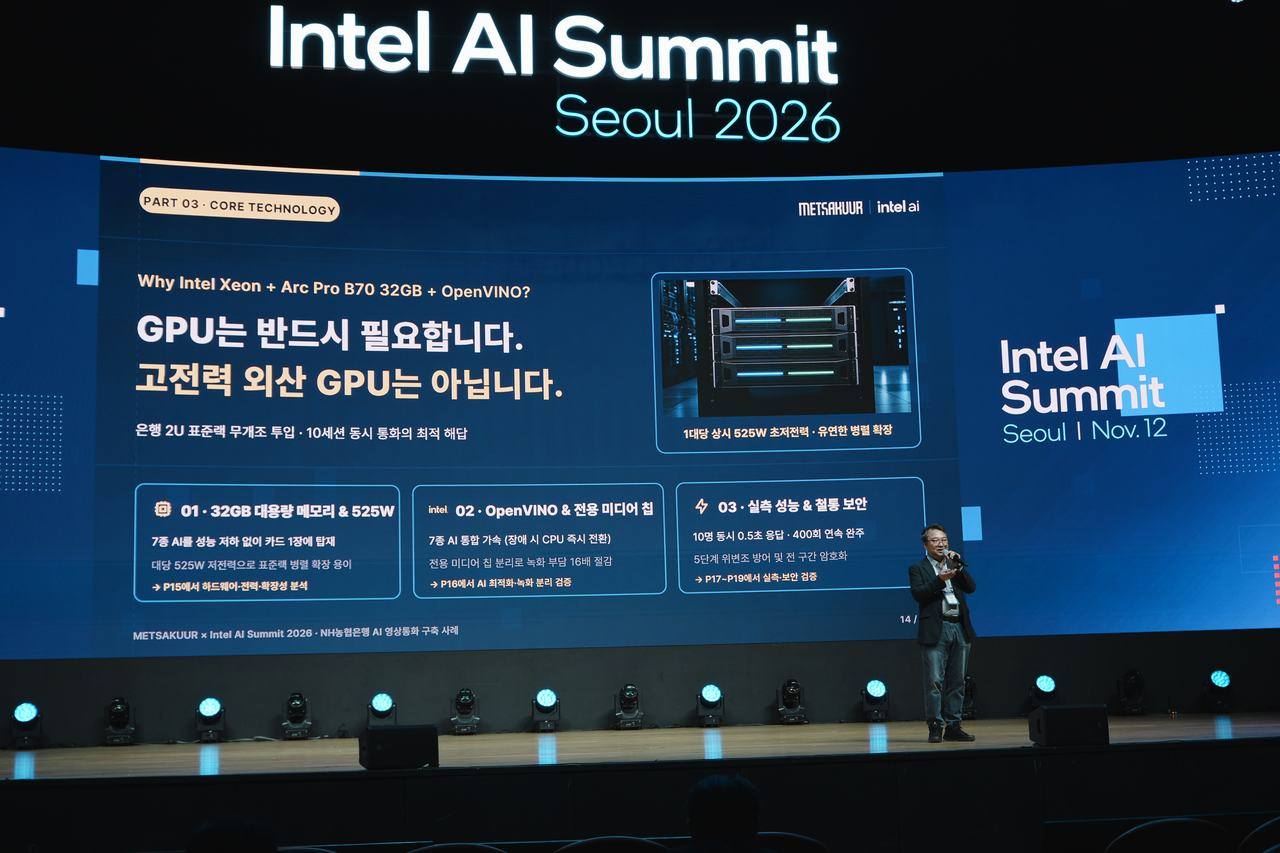
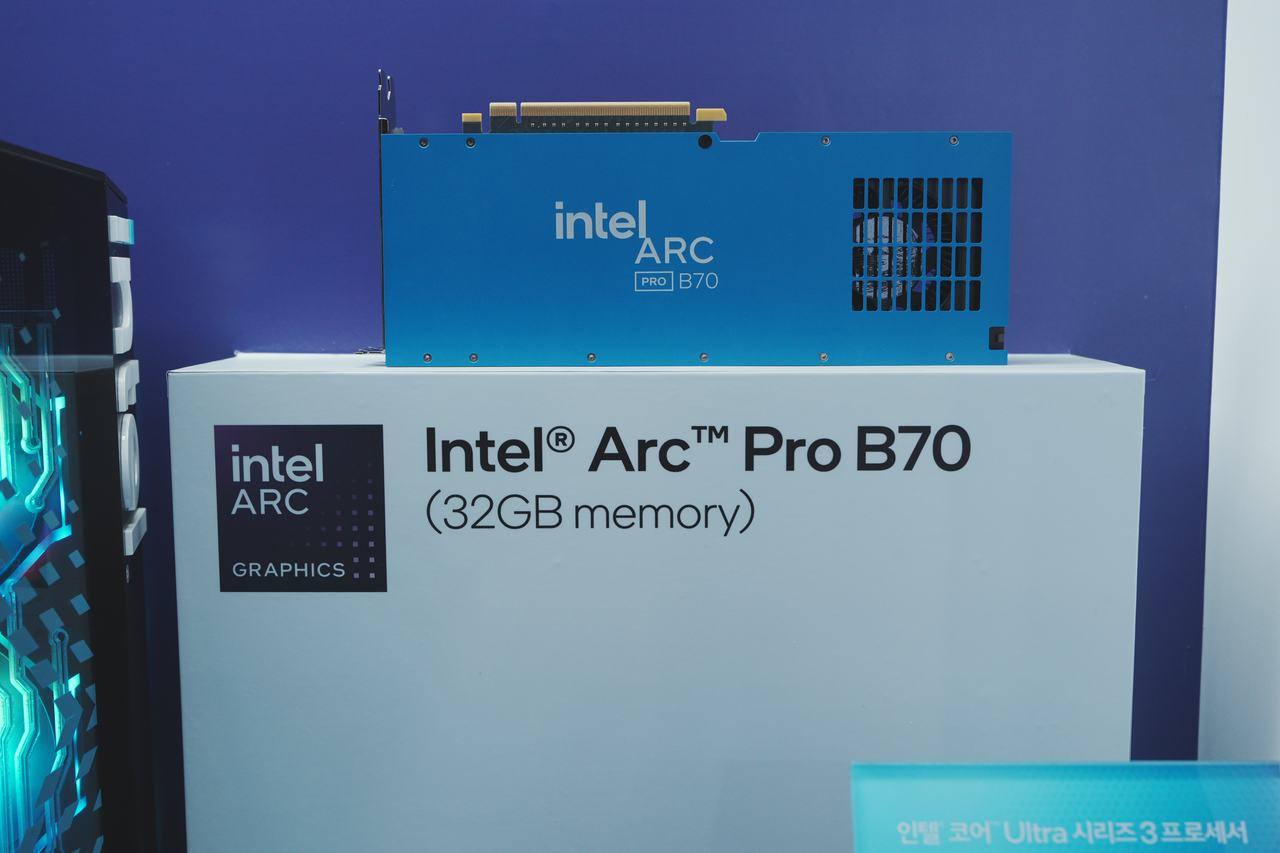
| 31 | 인텔 제품 · 기술 | Arc Pro B70 | Intel Arc Pro B70 | 이미 판매 중인 인텔 워크스테이션 GPU(32GB). 오후 메사쿠어·NH농협은행 사례에 쓰였습니다. |
| 32 | 인텔 제품 · 기술 | 제온 6 · P코어 · E코어 | Xeon 6 · Performance-core · Efficient-core | 인텔 서버 CPU. P코어는 한 코어가 빠른 고성능형, E코어는 작은 코어를 많이(최대 288개) 넣은 효율형입니다. |
| 33 | 인텔 제품 · 기술 | AMX | Advanced Matrix Extensions | 제온 CPU 코어마다 들어 있는 AI 행렬 계산 장치. GPU 없이 작은 모델을 돌릴 수 있게 해 줍니다. |
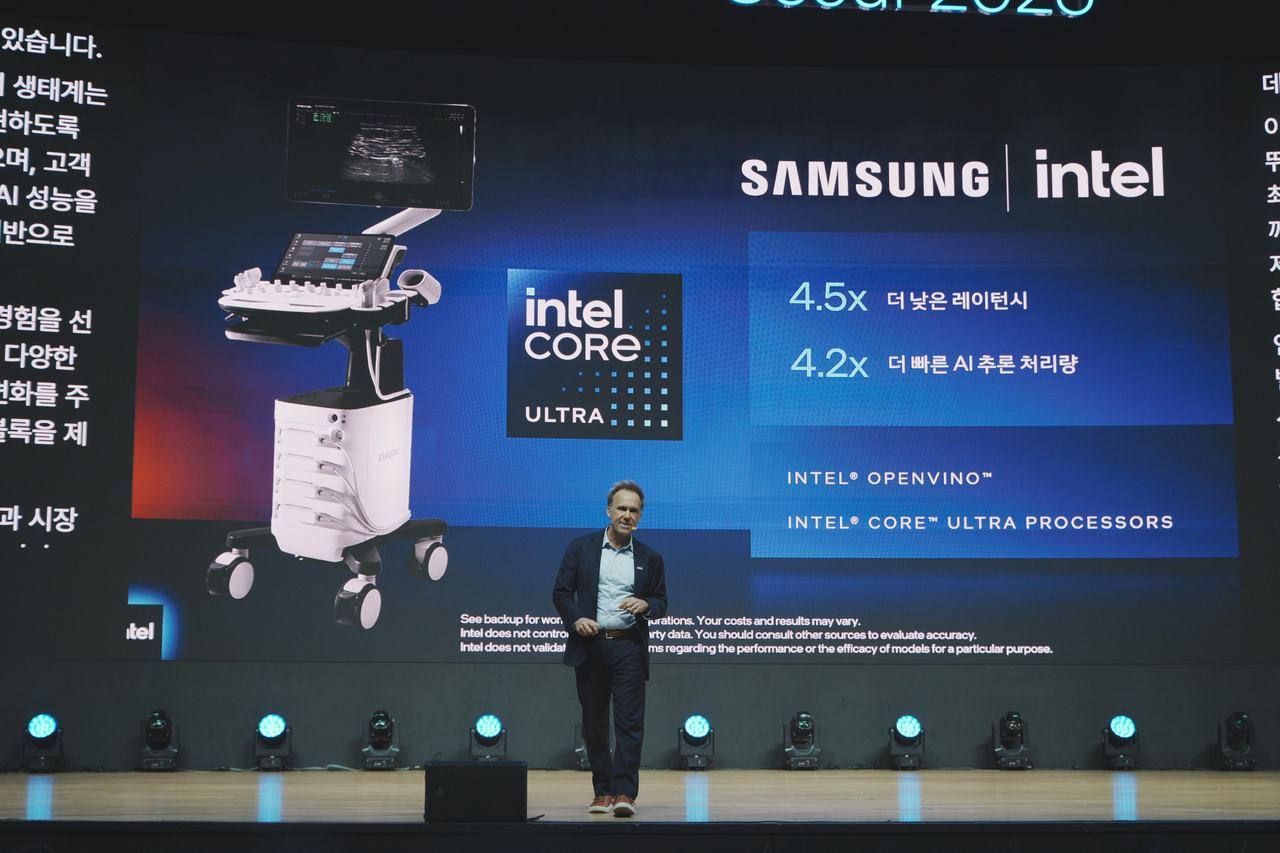
| 34 | 인텔 제품 · 기술 | OpenVINO | OpenVINO Toolkit | 인텔 칩(CPU·GPU·NPU)에서 AI 모델을 빠르게 돌리도록 최적화해 주는 무료 소프트웨어입니다. |
| 35 | 인텔 제품 · 기술 | TDX | Trust Domain Extensions | 실행 중인 데이터까지 암호화해 보호하는 인텔 보안 기술(기밀 컴퓨팅)입니다. |
| 36 | 인텔 제품 · 기술 | OCP ORv3 | Open Compute Project Open Rack v3 | 데이터센터 서버 랙의 공개 표준 규격. 여러 회사 장비를 같은 랙에 넣을 수 있습니다. |
| 37 | 통신 | MLO | Multi-Link Operation | 와이파이 7 기능. 2.4GHz와 5GHz 등 여러 대역을 동시에 써서 보내고 받는 것을 겹쳐 처리합니다. |
| 38 | 통신 | Multi-AP Coordination | Multi-AP Coordination | 와이파이 8 기능. 아파트처럼 공유기가 많은 곳에서 공유기끼리 정보를 나눠 서로 간섭을 줄입니다. |
| 39 | 통신 | AI Offload | AI Offload | AI 안경처럼 작은 기기가 하기 버거운 AI 계산을 집 안 AI PC 같은 가까운 기기에 넘기는 것입니다. |
| 40 | 금융 · 보안 | FDS | Fraud Detection System | 은행의 이상 거래 탐지 시스템. 수상한 거래가 잡히면 추가 인증을 요구합니다. |
| 41 | 금융 · 보안 | PAD | Presentation Attack Detection | 카메라 앞에 사진이나 영상을 들이대는 위조 시도를 잡아내는 기술입니다. |